데이터베이스 설계 중 모델링할 때 가장 중요한 것은 정규화이다. 제1정규화, 제2정규화 등의 용어는 실무에서는 외울 필요는 없고, 결국은 중복데이터를 최소화하는 것이다. 같은 데이터가 여러 테이블에 분산되어있으면 관리하기 어렵기 때문에 중복데이터를 없애고 관계를 단순하게 가져간다.
신입개발자 시절에는 테이블 하나에 데이터를 담는 게 단순한 것인 줄 안다. 그러나 데이터 모델링을 하다 보면, 성격이 다른 데이터는 서로 분리하는 것이 맞다. 이를테면 '학생', '수강신청' 테이블을 하나로 두면 코딩은 쉽겠지만 실제로 데이터베이스는 복잡해진다. 이는 실무에서 해보다보면 스스로 알게 되고, 따라서 이 정규화 과정은 실제로 해보면 몸에 체득이 된다. 무엇인지만 알고 있으면 자연스럽게 된다.
모든 속성은 하나의 값(Atomic Value)만 갖는다.
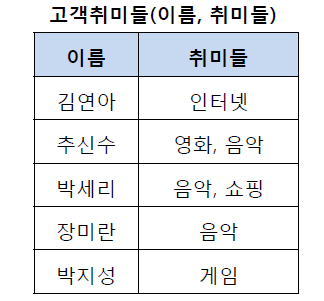
위 테이블을 보면 추신수, 박세리는 원자성을 준수하지 않는 것을 확인할 수 있다. 이에 1정규화 과정을 거쳐 원자성을 갖도록 분해할 수 있다.
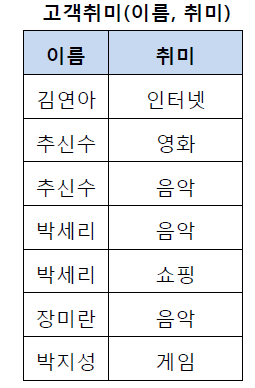
모든 속성은 기본키에 종속되어야 한다. 즉, table에 따라 종속되는 column들만 두자는 것.
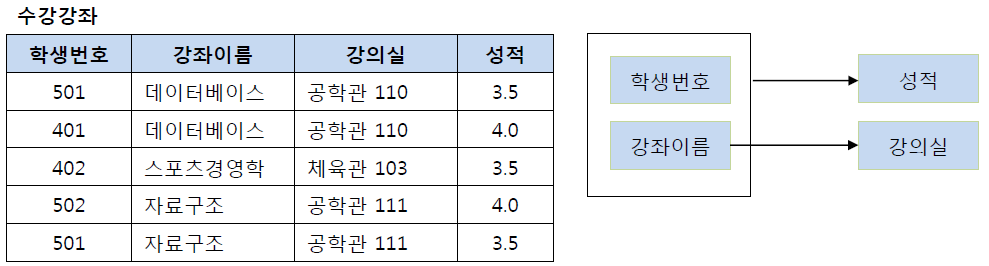
위와 같은 테이블에서 기본키는 (학생번호, 강좌이름)으로 이루어진 복합키이다.
모든 키는 기본키에 종속되어야 하는데, 값들을 보면 '강의실' 속성의 값들은 '강좌이름'에 의해 결정될 수 있다. 즉, 강좌 이름은 기본키(학생번호, 강좌이름)의 부분키인데, '강의실' 속성은 '강좌 이름'에 종속되어있다는 것이다. 이를 부분 함수적 종속이라고 하는데, 이를 분해하는 것을 2정규화라고 한다.
